2群間の比較では、データの分布や解析の目的に応じて、t検定などのパラメトリック検定やMann-WhitneyのU検定などのノンパラメトリック検定を選択します。
「パラメトリック検定とノンパラメトリック検定の違いとは?」では、両者の使い分けの考え方を解説しました。
今回は、ノンパラメトリック検定の代表的な手法の一つであるMann-WhitneyのU検定(Wilcoxon順位和検定)について、検定の考え方や計算方法、効果量の報告、EZRでの実行方法まで詳しく解説します!
Mann-WhitneyのU検定とは?
Mann-WhitneyのU検定は、対応のない2群のデータを順位に変換し、その順位に基づいて2群の分布の違いを検定するノンパラメトリック検定です。Wilcoxon順位和検定と呼ばれることもあり、一般に両者は同じ検定として扱われます。
対応のない2群の平均値を比較するt検定が「値そのもの」を用いるのに対し、Mann-WhitneyのU検定では「どちらの値が大きいか」という順位の情報を用います。
そのため、データが正規分布に従うことを前提とせずに検定でき、極端な値の影響もt検定などと比べて受けにくいという特徴があります。
Mann-WhitneyのU検定では、帰無仮説と対立仮説を以下のように設定します。
- 帰無仮説:2群の分布に差がない
- 対立仮説:2群の分布に差がある
p値があらかじめ設定した有意水準を下回った場合は帰無仮説を棄却し、2群の分布に統計学的に有意な差があると判断します。
一方、p値が有意水準以上の場合は、帰無仮説を棄却できず、2群の分布に差があるとはいえないと解釈します。
ただし、Mann-WhitneyのU検定を単純に「2群の中央値を比較する検定」と考えるのは正確ではありません。また、p値が有意でないことは「2群の分布が完全に同じ」という意味ではありません。検定の解釈については、後の「Mann-WhitneyのU検定は何を検定している?」の章で詳しく解説します。
検定の考え方
Mann-WhitneyのU検定では、2群のデータを1つにまとめて順位をつけ、その順位が2群のどちらかに偏っているかを確認します。
たとえば、A群の値がB群より全体的に大きければ、データをまとめて順位をつけたときにA群には高い順位が多く集まります。
一方、2群の分布に大きな違いがなければ、高い順位と低い順位は2群におおむね均等に分散すると考えられます。
そのため、Mann-WhitneyのU検定では各群の順位和(その群に割り当てられた順位の合計)を利用して、2群の順位にどの程度の偏りがあるかを数値化します。
この順位の偏りが、偶然だけでは説明しにくいほど大きいかどうかをp値によって判断します。
Mann-WhitneyのU検定の計算方法
Mann-WhitneyのU検定では、2群のデータをまとめて順位をつけ、その順位和からU統計量を計算します。基本的な計算手順は以下の4つです。
① データをまとめて順位をつける
まず、2群のデータをすべて1つにまとめ、値の小さい順に順位をつけます。
同じ値が複数ある場合(同順位、tie)は、それらの値が占める順位の平均順位を割り当てます。
たとえば、3位と4位に相当する2つの値が同じであれば、両方に3.5位を割り当てます。
② 各群の順位和を求める
次に、各群に割り当てられた順位を合計します。
群1のサンプルサイズをn₁、順位和をR₁、群2のサンプルサイズをn₂、順位和をR₂とすると、
R₁+R₂ = N(N+1)/2
という関係があります。ここで、N=n₁+n₂は2群を合わせた全体のサンプルサイズです。
③ U統計量を計算する
各群の順位和から、以下の式でU統計量を計算します。
U₁ = R₁ − n₁(n₁+1)/2
U₂ = R₂ − n₂(n₂+1)/2
U統計量は、一方の群の値がもう一方の群より大きい(または小さい)組み合わせの数に対応する指標と考えることができます。
検定統計量としては、通常、
U = min(U₁, U₂)
として小さい方のUを用います。
④ p値を求める
最後に、求めたU統計量が帰無仮説のもとでどの程度珍しい値なのかを評価し、p値を求めます。
実際の解析では、統計ソフトを使用してp値を計算することが一般的です。
次の章では、具体的なデータを使って、順位の付け方からU統計量の計算までを実際に確認してみましょう!
実際の計算例
実際の数値を使って、Mann-WhitneyのU検定の計算方法を確認してみましょう。
ある指標について、A群(4例)とB群(4例)で以下のような値が得られたとします。A群には22という極端に大きな値が含まれている点に注目してください。
| 群 | 値 |
| A | 2, 3, 5, 22 |
| B | 6, 7, 8, 9 |
① データをまとめて順位をつける
まず、A群とB群のデータをすべて1つにまとめ、値の小さい順に順位をつけます。
| 値 | 2 | 3 | 5 | 6 | 7 | 8 | 9 | 22 |
| 群 | A | A | A | B | B | B | B | A |
| 順位 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
今回は同じ値がないため、1位から8位までそのまま順位をつけることができます。
② 各群の順位和を求める
次に、各群に割り当てられた順位を合計します。
A群の順位和は、
1+2+3+8 = 14
B群の順位和は、
4+5+6+7 = 22
となります。
③ U統計量を計算する
各群の順位和からU統計量を計算します。
A群については、
14 − 4×5/2 = 4
となります。
同様に、B群については、
22 − 4×5/2 = 12
となります。
したがって、検定統計量として用いる小さい方のUは、
U = min(4, 12) = 4
となります。
このU=4は、A群とB群の値を1つずつ組み合わせて比較したとき、A群の値がB群より大きい組み合わせが4通りあることに対応しています。残りの12通りではA群の値がB群より小さくなっています。
④ p値を求める
今回のように各群4例とサンプルサイズが非常に小さい場合には、正確検定(exact test)によってp値を求めることができます。
この例で正確検定を行うと、両側p値は約0.343となります。
したがって、有意水準を5%とした場合、
p = 0.343 > 0.05
であるため、帰無仮説は棄却されません。このデータからは、2群の分布に統計学的に有意な差があるとはいえません。
ただし、p値が0.05以上であることは、「2群に差がない」ことを証明するものではありません。
今回のデータからは、統計学的に有意な差を示す十分な証拠が得られなかったと解釈します。
t検定と比較すると?
この例では、A群の平均値は、
(2+3+5+22)/4 = 8.0
B群の平均値は、
(6+7+8+9)/4 = 7.5
となり、平均値だけを見ると両群はほぼ同じです。
このように、極端な値が含まれると平均値はその値の影響を受けやすくなります。
一方で、Mann-WhitneyのU検定は順位を用いるため、極端な値そのものの大きさによる影響を受けにくいという特徴があります。
Mann-WhitneyのU検定は何を検定している?
Mann-WhitneyのU検定は、単純に「2群の中央値が異なるか」を検定しているわけではありません。
Mann-WhitneyのU検定では2群からそれぞれ1つずつ値を取り出して比較したとき、一方の群の値がもう一方の群より大きくなる傾向があるかを順位に基づいて検定しています。
たとえば、A群とB群から1例ずつ取り出して比較した場合、A群の値がB群より大きい組み合わせが多ければ、A群の方が大きな値を取りやすい傾向があると考えられます。
反対に、A群の値がB群より小さい組み合わせが多ければ、A群の方が小さな値を取りやすい傾向があると考えられます。
このような2群間の順位の偏りをU統計量によって数値化し、その偏りが偶然だけで生じたと考えにくいかどうかをp値によって評価します。
なお、2群の分布の形が同じで位置だけが異なる場合には、結果を中央値などの位置の違いとして解釈できることもあります。一方、分布の形やばらつきが異なる場合には、単純に「中央値の差」と解釈できない点に注意が必要です。
t検定との使い分け
Mann-WhitneyのU検定とt検定はいずれも、対応のない2群を比較するための検定です。
ただし、利用する情報や検定の考え方が異なります。
| t検定 | Mann-WhitneyのU検定 | |
| 主に利用する情報 | 元の値(連続値) | 順位 |
| 主な比較の対象 | 平均値 | 2群間の順位の偏り |
| 外れ値の影響 | 受けやすい | 比較的受けにくい |
| 正規分布の仮定 | 仮定する | 正規分布を仮定しない |
t検定ではデータをそのまま扱って平均値の差を評価します。
一方、Mann-WhitneyのU検定ではデータを順位に変換し、2群の順位に偏りがあるかを評価します。
また、t検定は外れ値の影響を受けやすいため、極端な値が含まれている場合には、平均値がその値に引っ張られてしまうことがあります。Mann-WhitneyのU検定では順位を用いるため、値の大きさそのものによる外れ値の影響を比較的受けにくいという特徴があります。
そのため、平均値を比較したい場合はt検定、外れ値の影響を抑えながら順位に基づいて2群を比較したい場合はMann-WhitneyのU検定が選択肢となります。
ただし、「正規分布ではないからMann-WhitneyのU検定」という単純な使い分けではありません。比較したい対象や外れ値、データの分布などを考慮して、目的に合った検定方法を選択することが重要です。
正確検定と正規近似
Mann-WhitneyのU検定でp値を求める方法には、主に正確検定(exact test)と正規近似があります。
正確検定では、帰無仮説のもとでU統計量が取りうるすべての組み合わせを考えて、p値を計算します。特にサンプルサイズが小さい場合に適しています。
一方、サンプルサイズが大きくなると、U統計量は近似的に正規分布に従うため、正規近似を用いてp値を計算できます。
また、同順位(tie)がある場合には、正規近似で同順位を考慮した補正が行われます。
統計ソフトではこれらの計算が自動的に行われるため、実際の解析では使用するソフトの設定や出力を確認することが重要です。
どちらの方法を使用するかは、サンプルサイズや同順位の有無などを考慮して判断します。
EZRでの実行方法
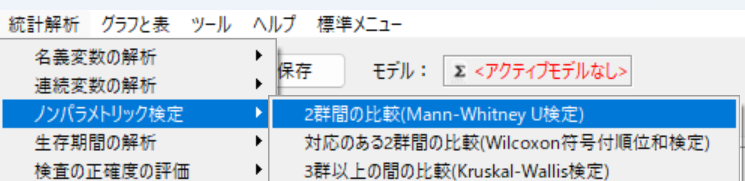
EZRでは [統計解析] → [ノンパラメトリック検定] → [2群間の比較(Mann-Whitney U検定)] を選ぶことでMann-WhitneyのU検定(Wilcoxon順位和検定)が実行できます。
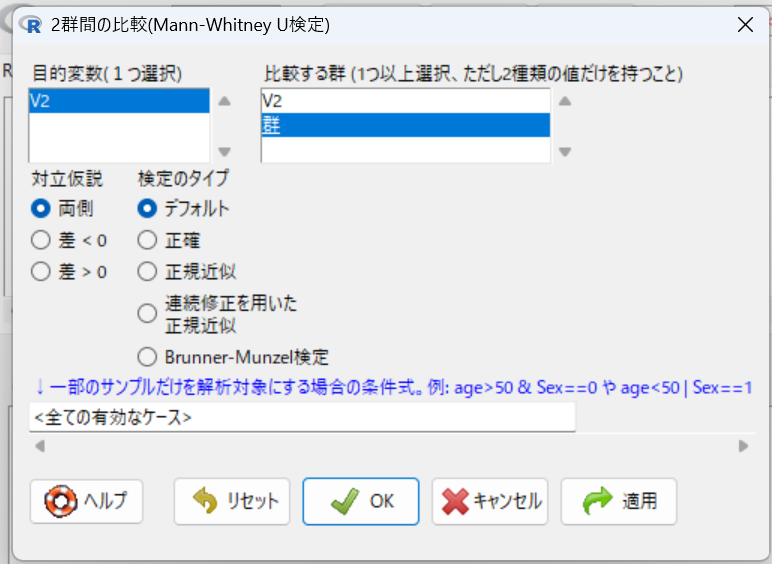
先ほどの数値例を用いてEZRの出力を確認してみましょう。
[2群間の比較(Mann-Whitney U検定)] を選択すると以下のようなウィンドウが開きます。
目的変数に「比較したい値」を、比較する群に群の変数を選択しましょう。
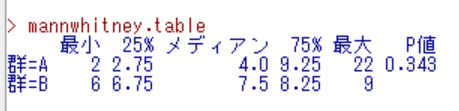
すると出力側に以下のような結果が出力されます。これからp値は0.343であることが分かりました。有意水準0.05では2群の分布に統計学的に有意な差があると結論付けられなかったことになります。
余談:t検定もやってみよう!
EZRでt検定を行うには [統計解析] → [連続変数の比較] → [2群間の平均値の比較(t検定)]を選択します。
変数の選択はMann-WhitneyのU検定と同じなので省略しますが、結果は以下のように出力されます。
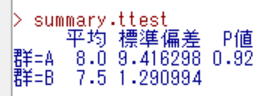
p値はMann-WhitneyのU検定の0.343と異なり、0.92となりました。
これは群Aに含まれる外れ値が平均値を引き上げており、両群の差が小さくなっているためです。
そのため、群間の連続変数を比較するときには、外れ値が含まれていないか、分布が偏っていないか、を確認する必要があります。
結果の報告例
Mann-WhitneyのU検定の結果を報告する場合は、各群の中央値(IQR)などの記述統計量と、検定結果をあわせて示します。
たとえば、以下のように報告できます。
A群の中央値(IQR)は4.0(2.5–13.5)、B群は7.5(6.5–8.5)であり、Mann-WhitneyのU検定では有意な差は認められなかった(U=4、p=0.343)。
検定結果だけでなく、各群の中央値やIQRを示すことで、実際のデータがどのような分布であったのかを読者が把握しやすくなります。
また、研究論文では、必要に応じて効果量やその信頼区間をあわせて報告することで、統計学的有意性だけでなく、群間の差の大きさについても示すことができます。
まとめ
今回はMann-WhitneyのU検定(Wilcoxon順位和検定)について解説しました!
- Mann-WhitneyのU検定は対応のない2群のデータを順位に変換して比較するノンパラメトリック検定
- 2群の中央値そのものを直接検定するのではなく、2群間の順位の偏りを評価する
- t検定と比べて外れ値の影響を受けにくく、正規分布を仮定しないという特徴がある
- 結果を報告する際には、p値だけでなく、各群の中央値や四分位範囲(IQR)などの記述統計量もあわせて示すことが重要
Mann-WhitneyのU検定は、2群のデータを順位に置き換えることで、外れ値の影響を比較的抑えながら群間の違いを評価できる便利な方法です。
一方で、検定結果を「中央値の差」と単純に解釈できない場合もあるため、実際のデータの分布を確認したうえで結果を解釈しましょう!
コメント